摘要: 北京时间2026年9月2日凌晨,李飞飞联合创办的World Labs正式发布全球首个多模态世界模型Atlas。这款面向空间智能的omni世界模型可原生处理文本、图像、视频、相机位姿与3D深度信息,一张照片即可生成任意角度视图,最长可输出1分钟1440p分辨率的相机控制视频;在稀疏视角3D重建任务中,Atlas以25.3的误差分数(AbsRel×10⁻³)大幅领先Pi3X、Depth Anything 3等竞品;在真人盲测中,其镜头运动控制对Seedance 2.5的胜率高达94%。Atlas的发布标志着AI竞争从语言智能、视频生成正式进入空间智能与世界模型的新阶段,也为具身智能与机器人训练提供了Real to Sim的低成本路线。
一、全球首个多模态世界模型Atlas正式发布 视频生成赛道被重新定义
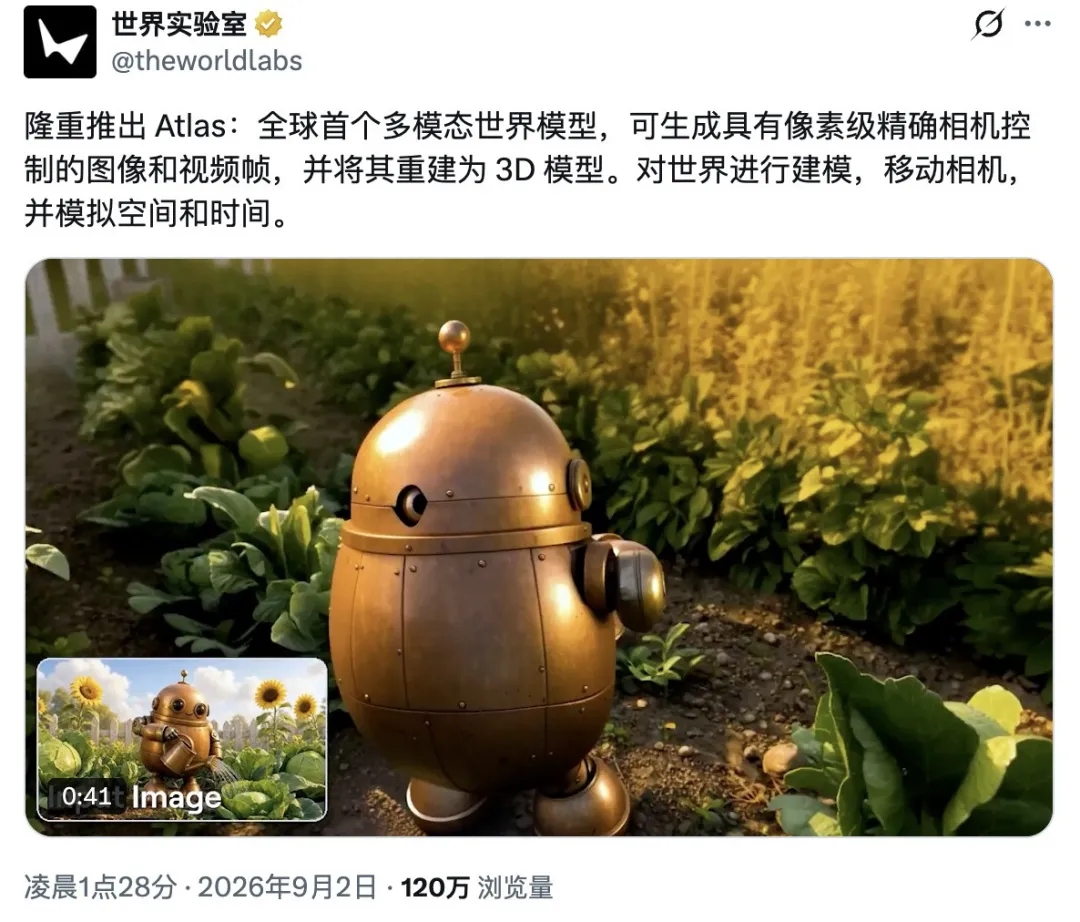
当大部分AI公司还在视频生成领域内卷,比拼谁能多生成几秒钟的“电子榨菜”时,李飞飞创办的World Labs选择直接掀桌子。2026年9月2日凌晨1点28分,全球首个多模态世界模型Atlas正式登场,相关发布内容在数小时内浏览量突破120万。
按照官方定义,Atlas是一款面向空间智能的omni world model(全模态世界模型),从零开始完成预训练,可以原生处理文本、图像、视频、相机位姿与3D深度信息,并在同一套模型中完成世界生成、空间重建和时空模拟三大任务。
与传统视频生成模型“抽卡式”的运镜体验不同,Atlas最直观的突破是Camera Controlled Generation(相机控制生成)能力。过去用户在提示词框里敲下“镜头缓慢向左拉升、绕着人物微仰角旋转”,生成结果全凭运气;而Atlas直接把相机位姿参数作为底层原生输入,用户只需输入1到6张普通照片并定义运镜轨迹,就能生成最长1分钟、1440p分辨率的高质量视频,画面空间几何保持丝滑一致。
二、单图脑补三维世界 Atlas的空间理解能力有多强
Atlas展现出的空间“脑补力”令人印象深刻。输入一张只拍到机器人正面的照片,Atlas能完整推理出它的背影;给一张泳池边角照片,它能依据世界常识补全画面之外的草坪和远山,生成任意角度的视图。
这一能力背后是一个名为Spatial Context(空间上下文)的核心机制。类比大语言模型通过上文预测下文,Atlas为每张图片绑定三维坐标和深度信息,在模型内部构建出带轴网的三维空间。它能把来自不同角度、不同机位的图片和视频统一放进同一个三维空间,先判断相对位置关系,再补足未拍摄区域,生成新视角。甚至两张毫不相关的照片,Atlas也能“脑补”出走廊、大门和房间,将两个场景无缝衔接。
当然需要客观指出的是,当镜头进入原图未覆盖的区域时,Atlas仍需依赖模型先验进行推测。视角跨度越大、生成路径越长,局部几何漂移、物体形状变化和纹理闪烁也越容易出现。它生成的更像是一个视觉上合理的三维世界,而非原始世界的精确数字复刻。
三、空间重建精度碾压级表现 2到25张照片替代专业3D扫描
Atlas的第二张王牌是Spatial Reconstruction(空间重建)。传统的3D高斯泼溅或点云扫描需要专业设备围绕目标拍摄几百上千张照片,成本高昂。而Atlas只需2到25张普通地面平拍照片,就能完成高精度三维重建。
官方展示的斯坦福大学Main Quad案例中,仅需少量游客视角照片,Atlas就还原了草坪、拱廊以及纪念教堂外墙的全部细节,并支持上帝视角的航拍漫游。
在DTU、ETH3D、ScanNet等公开数据集的稀疏视角重建误差测试(AbsRel×10⁻³,分数越低越好)中,Atlas拿下25.3分的成绩,明显优于Pi3X的28.7、Depth Anything 3的39.3和MapAnything的47.7。输出方面,Atlas直接对接点云和3D Gaussian Splatting格式,可无缝接入World Labs自家的Marble平台实现高帧率即时渲染。
更惊艳的是“子弹时间”式的Reframing Video功能:不需要好莱坞几百台相机的环形阵列,只需三五部手机和运动相机随手拍摄,Atlas就能在虚拟空间中自由切换视角,复刻《黑客帝国》式的经典镜头。
四、剑指具身智能 Real to Sim或改写机器人训练范式
李飞飞和World Labs的终极目标并非与好莱坞抢特效饭碗,而是直指当前AI最大的痛点:具身智能与机器人训练。
具身智能的核心瓶颈在于“虚拟训练场不够用”。让机器人真实地在工厂、仓库和家庭中试错,数据采集慢、成本高;而在仿真环境中训练,又需要大量人力搭建3D场景、材质、光照和物体。业内甚至有估算认为,若完全依靠传统方式收集足够规模的机器人训练数据,最终成本可能达到100万亿美元的量级。
Atlas给出的Real to Sim路线,相当于省掉了人工搭建仿真世界的中间环节:用手机拍摄两段24帧的工厂或房间视频喂给模型,Atlas即可生成高精度3D物理空间,机器人就能在这个数字孪生空间里反复试错。机器人走到哪里,Atlas就实时渲染出机载摄像头应有的RGB图和深度图;机械臂碰刚性箱子、拉铰链柜门、捏软体海绵,Atlas都能模拟出相应的受力反馈。一段真实场景录像,就能衍生出千万种光照、摆放和障碍物条件的训练数据。
五、多模态自回归扩散Transformer 技术架构解析
技术底座上,World Labs为Atlas打造了一套Multimodal Autoregressive Diffusion Transformer(多模态自回归扩散Transformer)架构,兼采当前两大主流范式之长:
- Multimodal(多模态): 原生融通文本、二维图像、相机位姿与3D深度信息;
- Autoregressive(自回归): 像语言模型预测下一个词一样,在时空序列中逐级预测新的空间状态;
- Diffusion(扩散机制): 基于Rectified Flow逐步去噪,确保连续高维信号的画质与几何精度;
- Transformer: 以成熟的矩阵乘法结构为底座,无缝适配现有大规模算力集群。
这套架构让Atlas能同时受益于大语言模型领域的KV Cache与分布式推理优化,以及扩散模型的采样蒸馏与先验引导技术。
在镜头运动控制的真人盲测中,Atlas几乎呈现碾压态势:面对MiniMax H3胜率75%,面对Gemini Omni Flash胜率81%,面对FLUX 3胜率93%,面对Seedance 2.5胜率更是高达94%。
此外,Atlas还具备不错的图像生成能力,可处理复杂提示词、文字渲染以及写实、电影感、油画、漫画等多种风格,甚至能根据文字或图片直接生成360°全景图——这对模型的空间连续性理解提出了更高要求。
六、暴力Scaling依然是版本答案 空间智能是通往现实世界的入场券
World Labs在Atlas身上强调的另一个关键词是Scaling。官方博客提到,随着参数量和算力成倍增长,模型展现出类似大语言模型的涌现能力,这意味着暴力缩放依然是世界模型当前的版本答案。
目前Atlas已向部分合作伙伴开放Early Access(早期访问),未来将成为Marble及World Labs其他产品的底层模型。
从二十年前奠基计算机视觉的ImageNet,到斯坦福实验室十年深耕视觉与机器人学习,再到创办World Labs,李飞飞始终在死磕同一条轨道。ImageNet解决的是“让机器在像素中识别世界”,而她如今关心的是更难的问题:机器看到一张图之后,是否真正理解背后的三维空间以及下一秒会发生什么。
李飞飞曾把今天的大语言模型形容为“黑暗里的文字高手”——能谈论现实,却缺少生活在现实中的经验。一个模型可以解释杯子为什么会从桌上掉下来,但机器人要真正伸手拿杯子,还需要知道杯子离桌边多远、手从哪个方向过去、碰到后场景会如何变化。
大语言模型把互联网里的知识交给了机器,而世界模型争夺的,可能是机器从数字世界走向现实世界的那张最真实的入场券。Atlas所代表的空间智能,正是给发达的语言智能加上一层关于几何、物理、时间和行动的世界经验——这或许就是下一代AI竞争的主战场。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...