
Claude Fable 5.1 正式发布:Anthropic 新旗舰大模型跑分超越 GPT-5.6 Sol,综合成本最高降45%
摘要
北京时间2026年9月2日凌晨,Anthropic 正式发布新一代旗舰大模型 Claude Fable 5.1,并同步推出面向安全与生命科学研究人员的专业版本 Claude Mythos 5.1。官方称其为“全球最先进的编码和知识工作模型”,在 Terminal-Bench、CursorBench、GDPval 等多项基准测试中全面超越上一代 Fable 5 以及竞品 GPT-5.6 Sol,多项跑分屠榜。价格方面,Fable 5.1 缓存读取费用直降 75%,典型工作负载综合成本下降约 25%,高密度智能体(Agent)场景最高可省 45%。此外,新模型还上线了防蒸馏机制与反滥用水印,企业级隐私方案 EFS 也将在今秋分阶段推出。业内普遍认为,Anthropic 此举是在销售增长承压、筹备 IPO 的背景下,用“性能+性价比”双管齐下抢夺市场。
一、双模型齐发:Fable 5.1 与 Mythos 5.1 是什么关系
这次更新 Anthropic 一次推出了两个版本,底层其实是同一个模型,区别主要在于安全限制和开放范围:
- Claude Fable 5.1:面向普通用户、开发者和企业的公开版本,目前已登陆 Claude 全平台,并可通过 API、AWS、Google Cloud 和 Microsoft Azure 使用。
- Claude Mythos 5.1:限制更少的专业版本,主要面向经过审核的网络安全人员和生命科学研究者,普通用户暂时接触不到。
这一定位也呼应了 Anthropic 的一贯策略:能力越强,管控越细。更强的网络安全和生命科学能力,只通过审核制开放给专家使用。
二、跑分屠榜:把 GPT-5.6 Sol 甩开一截
从官方公布的数据看,Fable 5.1 在智能体编程、电脑操作、业务流程、知识工作和长期任务上全面超越上一代 Fable 5,并拉开了与 OpenAI 旗舰 GPT-5.6 Sol 的差距。核心基准测试成绩如下:
1. 智能体编码(Terminal-Bench 4.0)
Fable 5.1 得分 55.8%,上一代 Fable 5 为 42.0%,Opus 5 为 52.3%,而 GPT-5.6 Sol 仅 37.3%。专业版 Mythos 5.1 因为护栏更松、不被安全规则打断,更是飙到了 60.9%。
2. 编码实战(CursorBench 3.2.0)
Fable 5.1 拿下 73.4%,高于 Fable 5 的 70.5%、Opus 5 的 70.0% 和 GPT-5.6 Sol 的 67.2%,是跑过该测试的所有模型中最高的。
3. 知识工作(GDPval-AA v2)
Fable 5.1 得分 1853,明显领先 GPT-5.6 Sol 的 1711 和 Opus 5 的 1824。
4. 科研场景(Terminal-Bench-Science 0.1)
Fable 5.1 拿到 52.6%,是上一代 24.7% 的两倍多,GPT-5.6 Sol 仅 22.4%。5. 跨学科推理(Humanity’s Last Exam)
不带工具通过率 60.9%,带工具 65.0%,均优于前代与竞品。
6. 电脑操作(OSWorld 2.0)
部分得分 77.9%,严格得分 41.7%,同样全面领先。
7. 业务流程(AutomationBench)
31.4%,接近上一代 17.1% 的两倍,远超 GPT-5.6 Sol 的 19.6%。
8. 长任务稳定性
MongoDB 工程师让 Fable 5.1 无人值守连续跑数小时完成复杂原型;Ramp 的机器学习团队更是一次 38 小时无人值守运行中,让它自主发现并修正了被错误标签污染的实验数据,还跑完了六组并行实验。
在与 GPT-5.6 Sol 的直接对比中,多家第三方评测机构确认了 Fable 5.1 在编码、推理和综合性价比上的领先地位。有媒体评价其为“最强模型”接管基准测试榜首。
三、价格策略:地球最强模型也开始卷性价比
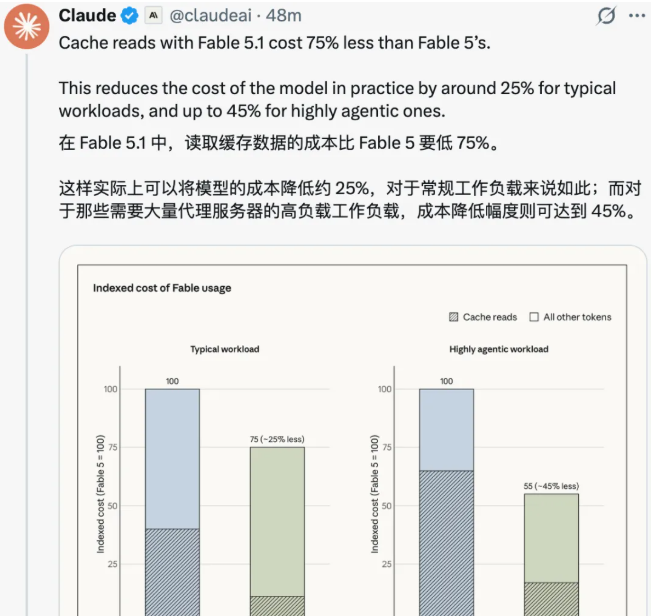
基础定价方面,Fable 5.1 与 Fable 5 保持一致:每百万 Tokens 输入 10 美元、输出 50 美元,上下文窗口 1M tokens,最大输出 128K tokens。
真正的大招在缓存读取:
- 缓存读取费用降低 75%;
- 典型工作负载下,综合使用成本下降约 25%;
- 高度智能体化(重上下文、重工具调用)的工作负载,成本最高下降 45%。
缓存读取是 Agent 类工作的成本大头——模型反复读取同一段上下文,读一次付一次钱。这次降价对天天跑 AI 编程、自动化工作流的用户来说,账单上会有肉眼可见的变化。
有分析指出,在销售增长放缓、传闻筹备 IPO 的背景下,Anthropic 用“降价换市场”的意图相当明显。此前被认为高冷的“地球最强大模型”,现在也开始强调性价比了。
四、企业级隐私:Enterprise Frontier Safeguards(EFS)
面向企业客户,Anthropic 同步宣布了新系统 Enterprise Frontier Safeguards(EFS):数据可以存在客户自己的云基础设施里,而不是 Anthropic 的服务器上,达到零数据保留级别的隐私,同时防滥用检测照常运行。该方案由 100 多家企业客户联合 AWS、谷歌云、微软 Azure 共同开发,今秋起分阶段上线。在那之前,合格客户可直接使用零数据保留版的 Fable 5.1。
五、更大的野心:模型开始参与科研
这次发布最值得关注的,是模型在真实科学场景中的表现:
- 蛋白质设计:Mythos 5.1 用开源蛋白质设计工具为 12 个靶点设计结合剂,官方称有效率接近 50%(行业常见水平仅 10%-15%),其中三个靶点的结合亲和力达到竞赛最佳设计的 10 倍,结果已经过外部实验室验证。
- 金星地形图:Fable 5.1 用 NASA 三十多年前的麦哲伦号雷达数据训练神经网络,制作出覆盖金星三分之一表面的新地形图,分辨率从 10-20 公里提升到 2-3 公里,地图以知识共享许可发布,供即将到来的 NASA VERITAS 和 ESA EnVision 任务参考。
- GPU 内核优化:Mythos 5.1 为七个开源生物模型编写定制 GPU 内核,推理最高提速 2.5 倍且输出完全不变,全基因组分析类任务的 GPU 成本估计可降 30%-60%。
六、安全与防滥用:能力越强,管得越细
模型能力越来越强,安全成为头部公司的共同难题。这次 Anthropic 主要做了三件事:
- 护栏更精准:网络安全场景误报减少 60%,生物学良性请求误报降低 85%;
- 能力边界清晰:Fable 5.1 可以协助发现软件漏洞,但生成漏洞利用、渗透测试仍被限制,更强的能力只通过审核制的 Mythos 5.1 开放给专家;
- 防滥用加码:新模型上线了防蒸馏机制,阻止第三方通过 API 输出“白嫖”训练新模型;同时按欧盟 AI 法案要求,模型输出加入不可见水印,新 API 账号不能手动编辑模型之前的对话。
七、值不值得升级?
从跑分和定价看,Fable 5.1 对重度 Agent 用户和编码用户几乎是“必升级”选项:更强、更稳、还更便宜。不过也有老用户表示,Opus 5 在某些场景下仍有自己的优势,是否全面切换因人而异。如果你正在 GPT-5.6 Sol、Opus 5 和 Fable 5.1 之间纠结,主流第三方对比评测普遍建议:编码和长时程智能体任务优先 Fable 5.1,日常轻量任务可继续用更便宜的 Sonnet 或 Haiku 系列。
另外一个好消息:官方发布新模型后,Anthropic 重置了所有用户的 5 小时和每周使用额度,现在正是上手体验的好时机。
文章来源
本文核心信息来自 Anthropic 官方发布内容及以下公开报道:
- Anthropic 官方:Claude Fable 5.1 与 Mythos 5.1 发布公告
- Heise:Anthropic enhances Claude: Fable 5.1 takes the benchmark lead
- 澎湃新闻:Anthropic上新Fable 5.1:综合成本最高降45%
- 凤凰科技:Claude最强Fable 5.1发布!8项屠榜,最高降价45%,反蒸馏机制上线
- VentureBeat:Claude Fable 5.1 and Mythos 5.1 arrive with a 75% cost reduction for Fable cache reads
- 界面新闻:“最强模型”Fable 5.1发布,Anthropic要用降价换IPO
- CNBC TV18:Anthropic’s Claude Fable 5.1 claims world’s best in coding, knowledge tasks
- OrcaRouter / UserightAI 等:Claude Fable 5.1 vs GPT-5.6 Sol 对比评测
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...